32GB 메모리서 180B MoE 구동 실험
최근 30일 조회수 —좋아요 —핵심 요약
전문가 가중치를 SSD에서 선택적으로 불러와 32GB 메모리로 180B MoE 모델을 구동했다.
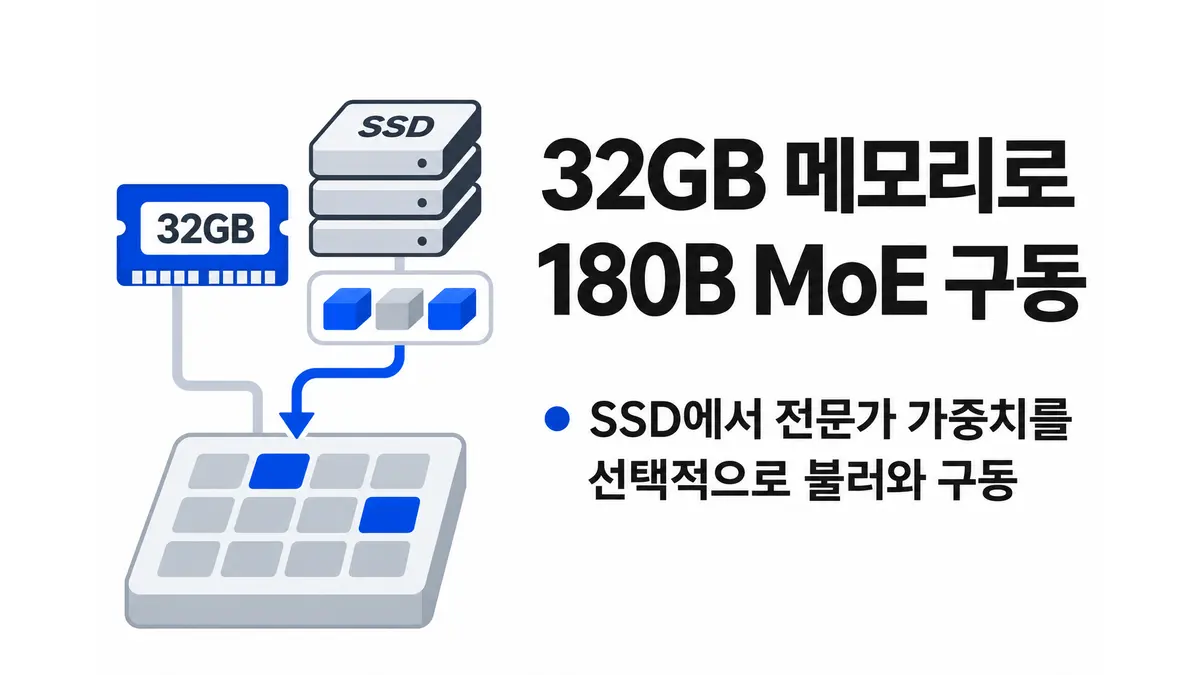
허깅페이스 커뮤니티가 1800억 매개변수 규모의 전문가 혼합(MoE) 모델을 32GB 메모리 환경에서 구동하는 실험을 공개했다. 핵심은 MoE 가중치의 90% 이상을 차지하는 전문가를 SSD에 두고, 라우팅된 전문가만 직접 불러오는 방식이다. 작성자는 토큰 생성 속도가 MoE 전용 추론 엔진 스트라타(Strata)보다 6% 이내로 느렸다고 밝혔다.1
기존 Transformers와 Accelerate의 오프로딩은 모듈 단위로 작동해, 토큰마다 실제로 쓰는 8~10개뿐 아니라 해당 계층의 전문가 전체를 GPU로 복사한다. 공유 메모리를 쓰는 맥에서는 CPU로 옮겨도 메모리가 확보되지 않는다. 반면 SSD 전문가 스트리밍은 모델 전체가 통합 메모리에 들어가지 않아도 추론할 길을 연다.
비교 실험은 별도 모델인 Qwen3.6-35B-A3B와 A10G 24GB 환경에서 진행됐다. 스트라타는 8288토큰/초, llama.cpp는 6364토큰/초, 전문가만 오프로딩한 vLLM FP8은 20.1토큰/초였으며 Transformers와 Accelerate는 0.16토큰/초에 그쳤다. 다만 이는 허깅페이스 블로그의 개인·커뮤니티 실험 결과로, 180B 모델의 구체적인 절대 속도는 제시되지 않았다.
Footnotes
-
Hugging Face 블로그·커뮤니티, 「180B Parameters, 32GB of RAM: Pushing MoE Inference to the Limit with Transformers」 ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- 180B Parameters, 32GB of RAM: Pushing MoE Inference to the Limit with Transformers — Hugging Face 블로그·커뮤니티 · 자료: 2026. 11. 18.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.